 生成AI・AIX / 社内DX
機密文書・社内SaaSログを安全に横断検索するエンタープライズRAGチャットボット構築
クライアント業種
製造業・商社 / 大手コンサルティングファーム
開発期間
約2.5ヶ月
提供スコープ
データ前処理パイプライン設計、ベクトルDB構築、RAG検索ロジック最適化、アクセス制御API開発
1. 課題と導入前のボトルネック
社内に蓄積された過去の技術仕様書、提案書、議事録、規程類が各部署のストレージやSaaSに分散し、必要な情報の検索に1日あたり平均45分を費やしていました。
- 汎用AIチャットでの情報漏洩リスク: パブリックなChatGPT等に機密データを入力することが社内規定で禁止されており、AI活用が進まない。
- ハルシネーション(嘘の回答)と精度の低さ: 単純なキーワード検索では、複雑な業界用語や文脈を踏まえた正確な回答が得られない。
- 閲覧権限に応じた情報アクセスの分離: 役員向け情報や人事情報が一般社員に漏洩しないよう、役職・部署に応じた閲覧制御が必須。
2. Ill(イル)株式会社による設計・開発アプローチ
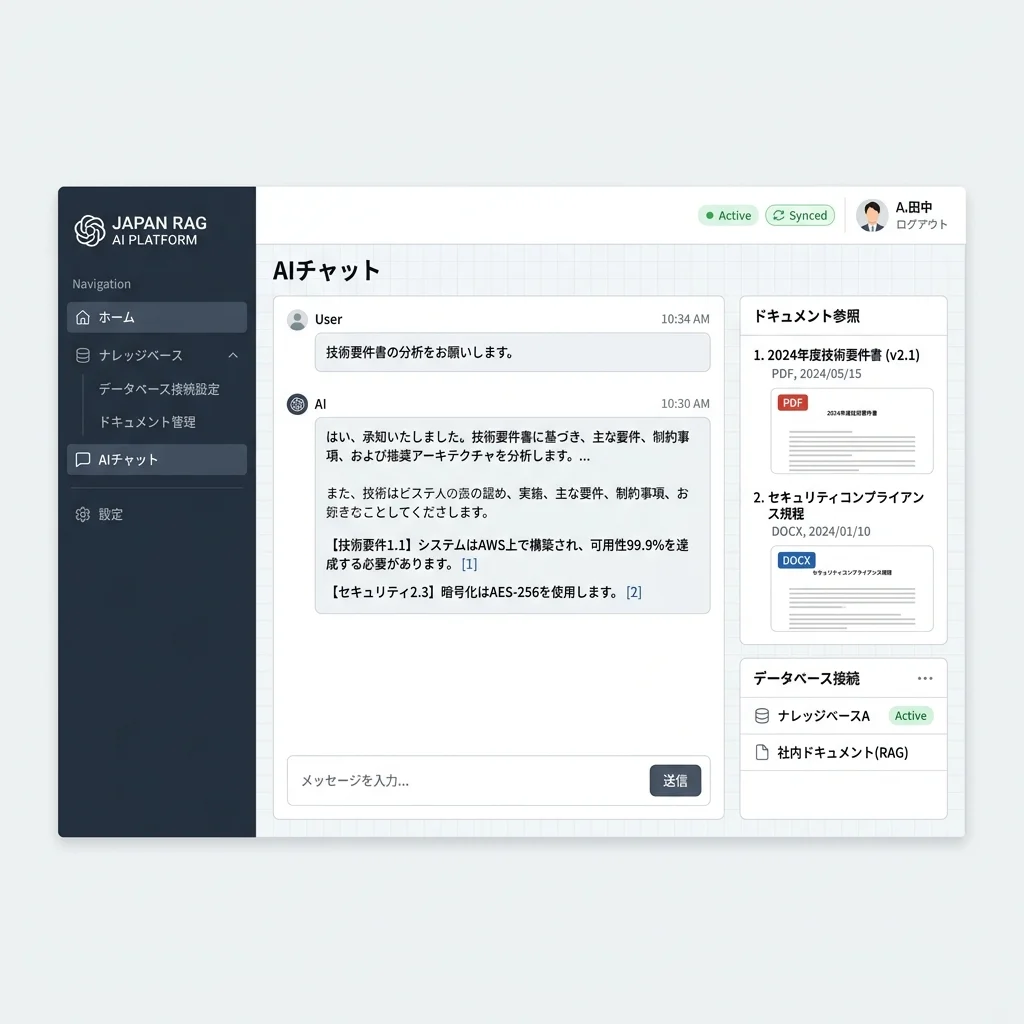
Ill(イル)株式会社 では、オプトアウト(学習拒否)契約のAPIと高度なチャンク分割・再ランキング(Re-ranking)アルゴリズムを組み合わせ、高精度な社内専用RAG基盤を構築しました。- ハイブリッド検索(Dense + Sparse Vector): キーワード完全一致検索(BM25)と意味検索(Dense Vector)を融合し、専門用語や型番検索でも漏れのない高精度検索を実現。
- ロールベース・アクセス制御(RBAC)連動: Microsoft Entra ID(旧Azure AD)と連携し、ユーザーの所属部署・役職がアクセス可能なドキュメントのみを検索空間として制限。
- 回答根拠(ソースドキュメント)のページ番号付き提示: 生成AIが回答を出力する際、参照した社内文書のリンクと該当ページを必ず引用表示し、ハルシネーションを防止。
- 自動ドキュメント同期バッチ: SharePointやGoogle Driveの更新を検知し、深夜バッチで差分ベクトル化を自動実行。
3. 導入効果とビジネスインパクト(ROI実績)
社内情報検索にかかる時間が1人あたり1日45分から5分へ大幅短縮(全社で月間約1,200時間の業務効率化)。
新人・若手社員の過去事例リサーチや営業提案書の作成スピードが2.5倍に向上し、社内ナレッジの属人化解消に大きく貢献しました。
よくある質問(FAQ)
Q. 社内データがAIモデルの再学習に利用されることはありませんか?
A. はい。Azure OpenAI ServiceやAWS Bedrockなど、入力データがモデルの学習に一切利用されないエンタープライズ契約のAPIのみを使用し、データ主権を完全保証します。
Q. 社内のPDFやスキャン画像(紙書類)も検索対象にできますか?
A. はい。OCRパイプラインを前処理に組み込むことで、紙の契約書やスキャンPDF、表組みデータも正確にテキスト抽出してベクトル化可能です。